Kapitel 1: Einleitung
In diesem Kapitel legen wir das Fundament für das Verständnis von MCP (Model Context Protocol). Warum brauchen wir es überhaupt und wie haben LLMs gelernt, mit der Außenwelt zu kommunizieren?
Was ist ein LLM?
Large Language Models (LLMs) wie GPT-4, Claude oder Llama sind im Kern statistische Modelle, die das nächste Wort in einer Sequenz vorhersagen können. Sie haben ein beeindruckendes Wissen über die Welt (aus ihren Trainingsdaten), sind aber von Natur aus "isoliert". Ein reines LLM kann keine E-Mails senden, keine aktuellen Aktienkurse abrufen und keine Dateien auf deiner Festplatte lesen.
Die Evolution der Tool-Calls
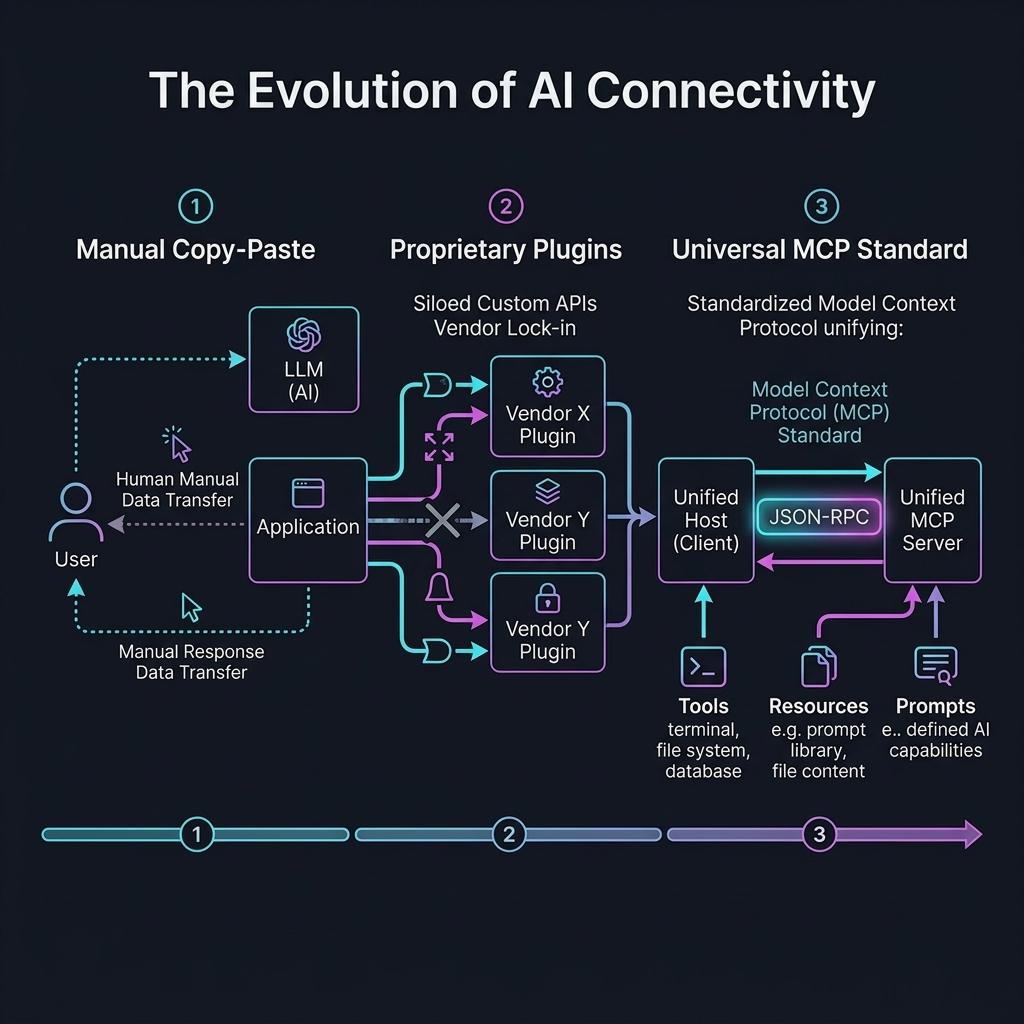
Die "Frühe Zeit": Manuelles Copy-Paste
Anfangs mussten Benutzer Ergebnisse von API-Abfragen manuell in den Chat kopieren. Das Modell gab Anweisungen ("Bitte suche nach X"), der Mensch führte sie aus und kopierte das Ergebnis zurück.
Die Ära der Plugins & Function Calling
OpenAI führte 2023 "Function Calling" ein. Entwickler konnten dem Modell beschreiben, welche Funktionen (APIs) verfügbar sind. Das Modell antwortete nicht mehr mit Fließtext, sondern mit einem strukturierten JSON-Objekt: "Ich möchte die Funktion get_weather mit dem Parameter city: Berlin aufrufen."
Der Nachteil: Jeder Anbieter kochte sein eigenes Süppchen. Ein Plugin für ein System funktionierte nicht in einem anderen.
Die Ära der Agentischen Skills & Progressive Disclosure (Heute)
Die neueste Entwicklung geht weg von statischen Tool-Listen hin zu modularen Agent Skills. Hierbei "weiß" das Modell zwar, welche Experten es rufen könnte, lädt deren detaillierte Anweisungen und Werkzeuge aber erst bei Bedarf nach. Dieses Prinzip der Progressive Disclosure schont das Gedächtnis (Kontext-Fenster) der KI und ermöglicht komplexeste Aufgaben, ohne das Modell zu verwirren.
Was ist MCP?
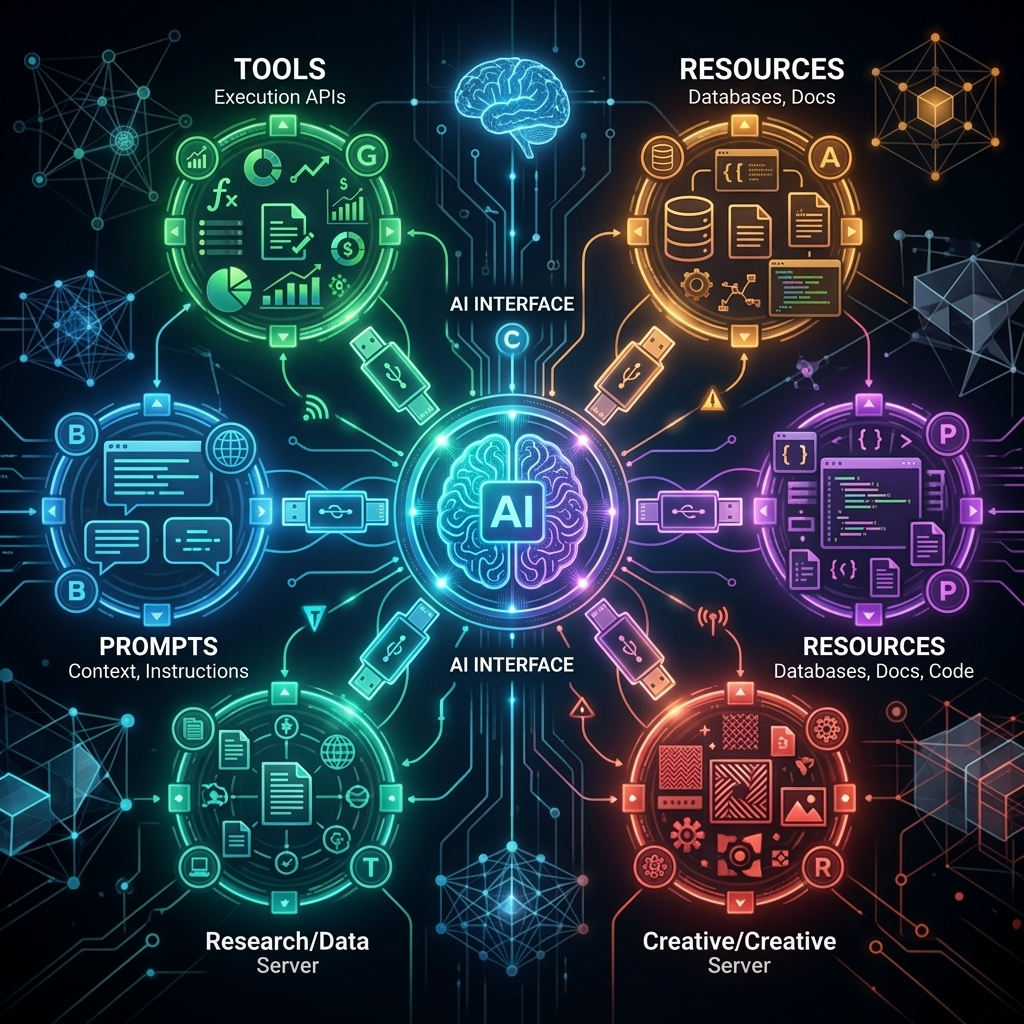
Das Model Context Protocol (MCP) ist der universelle, offene Industriestandard für diese Verbindung. Anstatt für jedes Modell und jede Plattform eine eigene proprietäre Schnittstelle zu bauen, schreiben Entwickler einen einzigen MCP-Server.
Jeder kompatible Client (wie Claude Desktop, moderne Agentic IDEs, Coding-Assistenten oder Test-Tools) kann sich mit diesem Server verbinden und sofort dessen Werkzeuge (Tools), Datenquellen (Resources) und Eingabevorlagen (Prompts) nutzen. MCP ist für künstliche Intelligenz das, was USB für Computer oder HTTP für das Web ist: Ein einheitlicher, universeller Standard-Stecker für alles.
Warum überhaupt eigene MCP-Server schreiben und betreiben?
Viele Entwickler und Teams fragen sich zu Beginn: „Es gibt doch bereits Hunderte fertige MCP-Server im Netz – warum sollte ich Zeit investieren, um eigene Server zu entwickeln und zu betreiben?“
Die Praxis zeigt drei fundamentale Gründe, warum maßgeschneiderte, eigene MCP-Server der entscheidende Hebel für produktive, verlässliche KI-Systeme sind:
1. Kuratierter, sicherer Zugriff auf sensible & lokale Daten (z. B. Datenbanken)
Ein LLM sollte niemals direkten, unbeschränkten Zugriff auf eine SQL-Produktionsdatenbank oder interne Dateisysteme erhalten (SELECT * FROM users, Schema-Interna, Passwörter, sensible Kundendaten).
- Ein eigener MCP-Server agiert als sicherer Gatekeeper: Er kapselt die Datenbank ab und bietet der KI ausschließlich eng umrissene, semantische Werkzeuge an (z. B.
get_customer_order_status(customer_id)). - Die Interna der Datenbank (Tabellennamen, SQL-Dialekt, Verbindungs-Credentials) bleiben vor dem Modell verborgen.
- Lokale Unternehmensdatenbanken (SQLite, Postgres hinter Firewalls) können so sicher für KI-Assistenten nutzbar gemacht werden, ohne dass sensible Rohdaten in eine externe Cloud exportiert werden müssen.
2. Schwächen des LLMs deterministisch umgehen: „Rechnen statt Denken“
Large Language Models sind probabilistische Sprachmodelle – keine Rechenmaschinen, Parser oder Compiler. Wenn ein Modell versucht, komplexe mathematische Formeln, Währungsumrechnungen, Regex-Filterungen oder Datenaggregationen rein über sprachliches „Reasoning“ zu lösen:
- Verschwendet es unzählige teure Reasoning-Tokens,
- Erzeugt es spürbare Latenzzeiten von 10–30 Sekunden,
- Und produziert am Ende oft subtile Rechenfehler und Halluzinationen.
Ein eigener MCP-Server löst dieses Problem durch deterministische Auslagerung: Das Modell formuliert die Rechenaufgabe oder Transformationslogik, und der Server führt sie in einer nativen, sicheren Umgebung in unter zwei Millisekunden exakt aus.
Genau dieses Prinzip demonstriert beispielsweise unser Open-Source-Server wollmilchsau (github.com/hmsoft0815/wollmilchsau · mlcgo.eu/products/wollmilchsau): Er stellt dem Modell eine isolierte TypeScript/V8-Sandbox bereit, damit das LLM mathematisch exakt rechnen, parsen und filtern kann, anstatt mühsam im Prompt zu raten.
3. Proprietäre Geschäftslogik & interne Systeme anbinden
Jedes Unternehmen besitzt eigene APIs, interne CLI-Werkzeuge oder Schnittstellen (von Warenwirtschaft über IoT-Sensoren bis hin zu Git-Workflows). Ein eigener MCP-Server verwandelt diese bestehende Infrastruktur mit minimalem Codeaufwand in ein standardisiertes Werkzeugset, das sofort in Claude Desktop, Cursor, VS Code oder autonomen Agenten wie Antigravity funktioniert.
Ziele dieses Handbuchs & Kontinuierliche Aktualisierung
Dieses Buch bietet eine praxisorientierte, architektonisch fundierte Einführung in die Welt von MCP. Es führt Sie in 24 Kapiteln Schritt für Schritt vom ersten „Hallo-Welt-Server" bis hin zu hochgradig optimierten, produktionsreifen Enterprise-Setups.
Ein lebendiges Dokument (Living Handbook)
Das MCP-Ökosystem und die zugehörige Spezifikation entwickeln sich in einem rasanten Tempo weiter:
- Streamable HTTP hat historische SSE-Doppelverbindungen abgelöst,
- OAuth 2.1 mit PKCE definiert den verbindlichen Sicherheitsstandard für Remote-Server,
- Tasks (SEP-2663) und agentische Server machen MCP-Server zu vollwertigen, asynchronen Sub-Agenten,
- Skills over MCP (SEP-2640) ermöglicht die standardisierte Auslieferung ganzer Experten-Workflows über das Drahtprotokoll.
Aus diesem Grund ist dieses Handbuch kein statisches, einmal geschriebenes Buch, sondern ein lebendiges Dokument. Wir pflegen und aktualisieren dieses Werk kontinuierlich, um es fortlaufend an den jeweils aktuellsten offiziellen Standard (modelcontextprotocol.io), neu verabschiedete SEPs (Specification Enhancement Proposals) und Praxiserfahrungen führender Implementierungen anzugleichen.
Strikte Standard-Konformität
Ein zentraler Schwerpunkt bei der Entwicklung von MCP-Lösungen ist die strikte Einhaltung der Spezifikation. Da unzählige verschiedene Clients, Frameworks und KIs auf Ihren Server zugreifen, führen kleinste Abweichungen im JSON-RPC-Protokoll oder Handshake sofort zu Inkompatibilitäten. Genau aus diesem Grund haben wir den Open-Source mcp-tester (github.com/hmsoft0815/mlc_mcptester) entwickelt: Er hilft Ihnen dabei, Ihren Server direkt gegen die Spec zu validieren, Spezifikationsänderungen frühzeitig aufzuspüren und über ein Punktesystem (Quality Score) gezielt zu optimieren (siehe Kapitel 14: Qualitätssicherung).
📋 Meta & Status
- Letzte Aktualisierung: 27. September 2026
- Version: 2.2.0 (Streamable HTTP, OAuth 2.1 / PKCE, Tasks-Extension / SEP-2663, agentische Server als Sub-Agenten, Elicitation, Skills over MCP / SEP-2640)
- Status: In aktiver, kontinuierlicher Pflege (Living Document)
- Autor: Michael Lechner
← Inhaltsverzeichnis | Nächstes Kapitel: Wie LLMs kommunizieren →
Copyright Michael Lechner – 2026-09-27 (Kontinuierlich gepflegtes MCP-Handbuch)