Kapitel 19: Tasks – Lang laufende Aufgaben & Asynchronität (Tasks-Extension, SEP-2663)
In den vorangegangenen Kapiteln haben wir gelernt, wie Tools unmittelbar auf Anfragen antworten: Ein Funktionsaufruf geht ein, der Server führt ihn synchron aus und liefert das Ergebnis in derselben Antwort zurück.
Doch was passiert, wenn eine Operation nicht 200 Millisekunden, sondern 5 Minuten oder gar zwei Stunden dauert? Denken Sie an:
- Das Trainieren oder Finetunen eines Machine-Learning-Modells,
- Das Durchsuchen von Millionen Logs oder Datenbankeinträgen,
- Einen aufwendigen Docker-Build oder Integrationstest-Lauf,
- Ein Code-Review durch ein lokales LLM, das erst das ganze Repository durchsuchen muss.
Synchrone Tool-Aufrufe führen in diesen Szenarien zu Timeouts, Verbindungsabbrüchen und einem blockierten KI-Modell. Die Antwort von MCP darauf ist Tasks: das asynchrone „Call-Now, Fetch-Later“-Muster.
Stand der Spezifikation: Tasks wurden mit SEP-1686 als experimentelles Kernfeature in
2025-11-25eingeführt. Mit der Spezifikation2026-07-28sind sie aus dem Kern in eine offizielle Extension gewandert:io.modelcontextprotocol/tasks, spezifiziert in SEP-2663 und im Repository modelcontextprotocol/ext-tasks. Dabei wurde das Protokoll deutlich vereinfacht –tasks/resultundtasks/listsind entfallen, die Task-Erzeugung entscheidet jetzt allein der Server. Dieses Kapitel beschreibt den Stand2026-07-28; die Unterschiede zur Vorversion fasst Abschnitt 9 zusammen.
1. Das Problem mit synchronen Tool-Calls
Klassische MCP-Tool-Calls arbeiten strikt nach dem Request-Response-Prinzip:
Client ──tools/call──► Server (blockiert 15 Min …) ──Result──► ClientDieses synchrone Modell scheitert bei langen Workflows an drei Problemen:
- Verbindungsabbrüche: HTTP-Proxies, Load Balancer und Clients kappen Verbindungen häufig nach 30 bis 60 Sekunden.
- Blockierter Agenten-Loop: Während der Client auf den Server wartet, ist der Chat blockiert. Der Assistent kann keine anderen Teilaufgaben parallel bearbeiten.
- Keine Wiederaufnahme: Stürzt der Client ab oder bricht die Verbindung, ist die Arbeit verloren – es gibt nichts, womit man später nachfragen könnte.
Tasks lösen alle drei: Der Server gibt statt des Ergebnisses einen dauerhaften Griff (taskId) zurück, über den der Client später – auch nach einem Neustart – den Stand abfragen kann.
2. Die Task-Architektur & der Lebenszyklus
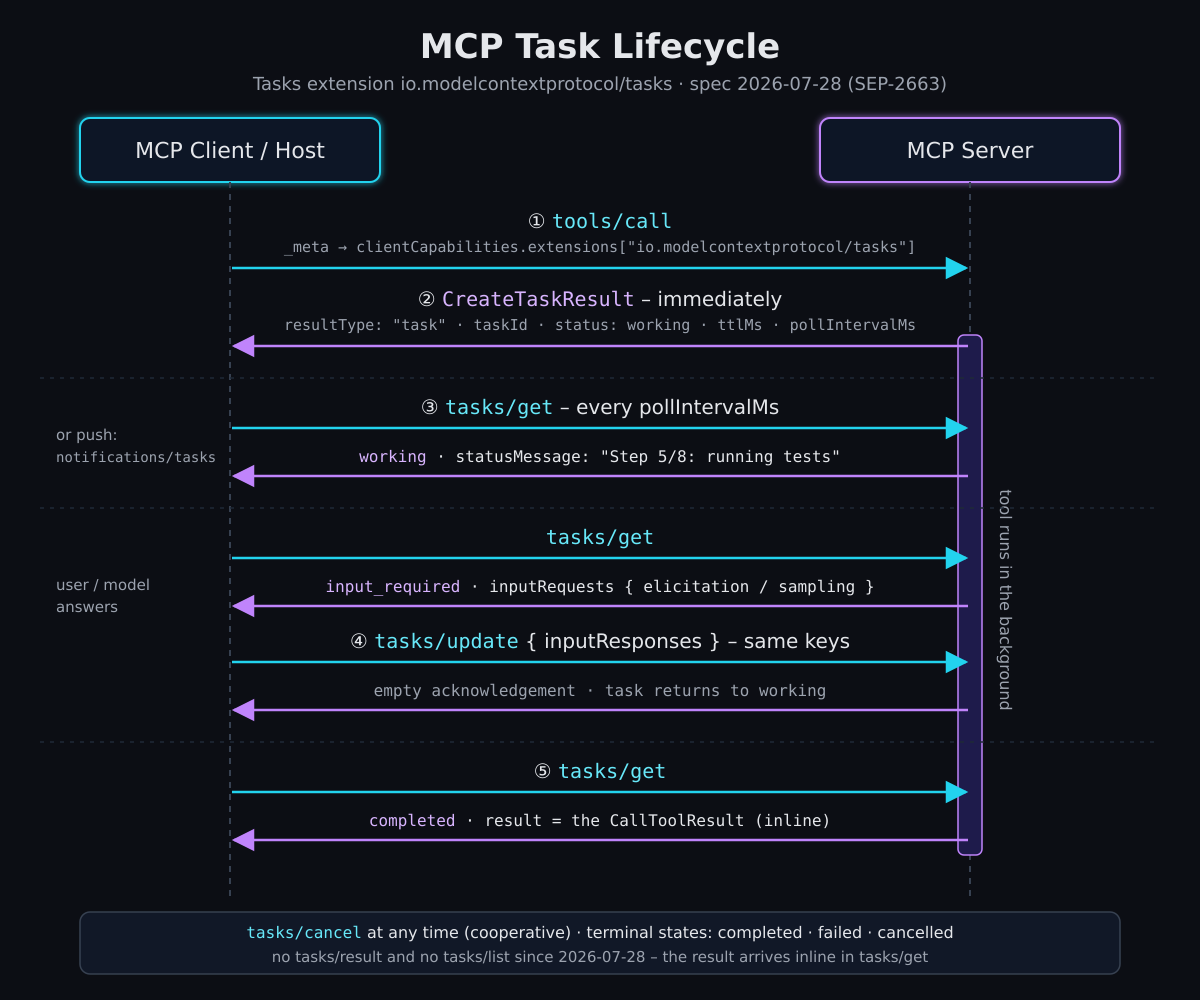
Der Ablauf in 5 Schritten
- Capability-Signal: Der Client nimmt die Extension in die Capabilities jeder Anfrage auf (
_meta→io.modelcontextprotocol/clientCapabilities). Der Server bewirbt sie in seiner Antwort aufserver/discover. - Tool-Aufruf (Call-Now): Der Client ruft das Tool ganz normal mit
tools/callauf. Ein Task-Flag pro Aufruf gibt es nicht. - Server entscheidet: Hält der Server die Arbeit für lang laufend, antwortet er sofort mit einem
CreateTaskResult(resultType: "task") statt einesCallToolResult. Der Task muss zu diesem Zeitpunkt bereits dauerhaft angelegt sein. - Beobachten: Der Client fragt den Stand mit
tasks/getab (im Takt vonpollIntervalMs) oder abonniertnotifications/tasks. Braucht der Task unterwegs Eingaben, liefert der Server sie alsinputRequests; der Client antwortet mittasks/update. - Ergebnis (Fetch-Later): Erreicht der Task
completed, steht das Ergebnis direkt in dertasks/get-Antwort im Feldresult– genau dasCallToolResult, das ein synchroner Aufruf geliefert hätte.
Wichtig ist der Perspektivwechsel gegenüber der Vorversion: Der Server ist der alleinige Entscheider. Ein Client, der die Extension deklariert, muss auf jede unterstützte Anfrage beide Antwortformen verarbeiten können. Ein Server darf einem Client, der die Extension in genau dieser Anfrage nicht deklariert hat, niemals ein CreateTaskResult schicken – kann er die Anfrage nur als Task bedienen, antwortet er mit Fehler -32021 (Missing Required Client Capability).
Derzeit unterstützt nur tools/call die Task-Ausführung; weitere Anfragetypen sind für spätere Revisionen vorgesehen.
3. Die Zustandsmaschine (Task State Machine)
                 ┌─────────────┐
      ┌─────────►│   working   │──────────────┐
      │          └──────┬──────┘              │
      │                 │                     │
      │                 ▼                     ▼
      │      ┌─────────────────┐     ┌──────────────────┐
      └──────│ input_required  │────►│  Endzustände:    │
 tasks/update└─────────────────┘     │  completed       │
                                     │  failed          │
                                     │  cancelled       │
└──────────────────┘working: Der Task läuft. Fortschritt wird als Freitext instatusMessagegemeldet (z. B. „Schritt 5/8: Tests laufen“). Ein numerisches Fortschrittsfeld gibt es nicht, undnotifications/progresswird für Tasks ausdrücklich nicht unterstützt.input_required: Der Task braucht Eingaben – etwa eine Bestätigung durch den Nutzer (Elicitation, Kapitel 21) oder eine LLM-Generierung (Sampling, Kapitel 20). Die offenen Anfragen stehen im FeldinputRequests; nach der Antwort pertasks/updatekehrt der Task zuworkingzurück.completed: Die Operation ist beendet;resultenthält das Ergebnis. Auch ein Tool-Ergebnis mitisError: trueistcompleted.failed: Ausschließlich für JSON-RPC-Fehler während der Ausführung; das Felderrorenthält den Fehler. Fachliche Fehler gehören nicht hierher (siehe oben).cancelled: Der Task wurde abgebrochen.
completed, failed und cancelled sind Endzustände – danach ändert sich der Task nicht mehr. Aus input_required kann ein Task direkt in einen Endzustand wechseln, etwa wenn er abgebrochen wird oder die TTL abläuft.
4. Die sofortige Antwort: `CreateTaskResult`
Statt stumm zu warten, erhält der Client sofort einen strukturierten Task-Griff:
{
  "jsonrpc": "2.0",
  "id": 1,
  "result": {
    "resultType": "task",
    "taskId": "786512e2-9e0d-44bd-8f29-789f320fe840",
    "status": "working",
    "statusMessage": "Docker-Build für 'auth-service:v2' gestartet.",
    "createdAt": "2026-10-09T10:30:00Z",
    "lastUpdatedAt": "2026-10-09T10:30:00Z",
    "ttlMs": 3600000,
    "pollIntervalMs": 5000
  }
}| Feld | Bedeutung |
|---|---|
resultType |
Diskriminator: "task" unterscheidet das CreateTaskResult von einem normalen Ergebnis ("complete"). |
taskId |
Vom Server erzeugte, nicht erratbare ID. Sie wirkt wie ein Bearer-Token für den Task-Zustand. |
statusMessage |
Optionaler Freitext für Nutzer oder Modell. |
ttlMs |
Lebensdauer ab Erzeugung in Millisekunden (null = unbegrenzt). Danach darf der Server den Task verwerfen. |
pollIntervalMs |
Empfohlener Abfragetakt. Clients sollen ihn einhalten, Server dürfen schnellere Abfragen drosseln. |
Der Host kann dem Modell daraufhin sofort antworten lassen:
„Ich habe den Build gestartet. Das dauert einige Minuten – soll ich in der Zwischenzeit die Dokumentation aktualisieren?“
Der Chat bleibt reaktionsfähig, während die Arbeit im Hintergrund läuft.
5. Das Task-Protokoll im Detail (RPC-Methoden)
Die Extension definiert genau drei Methoden. Alle Task-Antworten tragen resultType: "complete", weil sie die reguläre Antwortform ihrer Methode sind.
1. `tasks/get` – Status, Rückfragen und Ergebnis
Die zentrale Methode. Die Antwort enthält je nach Status zusätzliche Felder: inputRequests bei input_required, result bei completed, error bei failed.
// Request
{ "jsonrpc": "2.0", "id": 10, "method": "tasks/get",
  "params": { "taskId": "786512e2-9e0d-44bd-8f29-789f320fe840" } }

// Response (abgeschlossen)
{
  "jsonrpc": "2.0",
  "id": 10,
  "result": {
    "resultType": "complete",
    "taskId": "786512e2-9e0d-44bd-8f29-789f320fe840",
    "status": "completed",
    "createdAt": "2026-10-09T10:30:00Z",
    "lastUpdatedAt": "2026-10-09T10:33:12Z",
    "ttlMs": 3600000,
    "pollIntervalMs": 5000,
    "result": {
      "content": [{ "type": "text", "text": "Build erfolgreich. Image Digest: sha256:4a8f9..." }],
      "isError": false
    }
  }
}
2. `tasks/update` – Eingaben nachreichen
Steht der Task auf input_required, enthält tasks/get eine Map inputRequests. Ihre Werte sind gewöhnliche Server-an-Client-Anfragen (elicitation/create, sampling/createMessage oder roots/list); die Schlüssel vergibt der Server und verwendet sie während der Lebensdauer des Tasks nie zweimal.
// Ausschnitt aus tasks/get
"status": "input_required",
"inputRequests": {
  "confirm_push": {
    "method": "elicitation/create",
    "params": {
      "mode": "form",
      "message": "Image in die Produktions-Registry pushen?",
      "requestedSchema": {
        "type": "object",
        "properties": { "confirm": { "type": "boolean" } },
        "required": ["confirm"]
      }
    }
  }
}
Der Client legt die Anfrage dem Nutzer (oder Modell) vor und antwortet unter demselben Schlüssel:
{ "jsonrpc": "2.0", "id": 11, "method": "tasks/update",
  "params": {
    "taskId": "786512e2-9e0d-44bd-8f29-789f320fe840",
    "inputResponses": {
      "confirm_push": { "action": "accept", "content": { "confirm": true } }
    }
  } }
Der Server quittiert mit einem leeren Ergebnis. Die Quittung ist eventually consistent: Bis tasks/get wieder working zeigt, kann etwas Zeit vergehen. Weil inputRequests bei jeder Abfrage erneut geliefert werden, solange sie offen sind, soll der Client nach Schlüssel deduplizieren – sonst sieht der Nutzer dieselbe Rückfrage mehrfach.
Kein Kanal mit höherem Vertrauen: Eine Elicitation oder ein Sampling über
inputRequestsunterliegt exakt denselben Regeln wie die gleiche Anfrage außerhalb eines Tasks – inklusive Freigabe durch den Menschen.
3. `tasks/cancel` – Job abbrechen
{ "jsonrpc": "2.0", "id": 12, "method": "tasks/cancel",
  "params": { "taskId": "786512e2-9e0d-44bd-8f29-789f320fe840" } }
Der Abbruch ist kooperativ: Der Server muss quittieren, aber nicht anhalten. Der Task kann trotzdem noch completed erreichen, wenn die Arbeit schon fertig war. Der Client darf seinen Zustand zum Task sofort nach dem Senden verwerfen. notifications/cancelled darf für Tasks nicht verwendet werden.
Was es nicht (mehr) gibt
tasks/result– das Ergebnis steht jetzt intasks/get. Die alte Methode blockierte, bis der Task fertig war, und erzwang dauerhafte Verbindungen.tasks/list– entfallen, weil sich nicht sicher definieren lässt, wessen Tasks gelistet werden dürften. Ohne Liste kann ein Server auch nicht versehentlich die Tasks eines Aufrufers einem anderen zeigen. Konsequenz für Clients: Task-IDs selbst dauerhaft speichern, sonst sind sie nach einem Absturz verloren.
6. Polling vs. Push: `notifications/tasks`
Der Standardweg ist Polling über tasks/get im Takt von pollIntervalMs. Zusätzlich darf ein Server Statuswechsel pushen. Dazu meldet der Client sein Interesse über subscriptions/listen an und nennt die gewünschten Task-IDs:
{ "jsonrpc": "2.0", "id": 20, "method": "subscriptions/listen",
  "params": { "notifications": { "taskIds": ["786512e2-9e0d-44bd-8f29-789f320fe840"] } } }
Der Server bestätigt in notifications/subscriptions/acknowledged, für welche IDs er tatsächlich Benachrichtigungen schickt. Jede Benachrichtigung trägt den vollständigen Task-Zustand – inklusive result oder inputRequests –, sodass kein zusätzliches tasks/get nötig ist:
{
  "jsonrpc": "2.0",
  "method": "notifications/tasks",
  "params": {
    "taskId": "786512e2-9e0d-44bd-8f29-789f320fe840",
    "status": "completed",
    "createdAt": "2026-10-09T10:30:00Z",
    "lastUpdatedAt": "2026-10-09T10:33:12Z",
    "ttlMs": 3600000,
    "result": { "content": [{ "type": "text", "text": "Build erfolgreich." }], "isError": false }
  }
}
Routing über Streamable HTTP
Wird tasks/get, tasks/update oder tasks/cancel über Streamable HTTP (Kapitel 16) gesendet, muss der Client den Header Mcp-Name auf die taskId setzen. So können Load Balancer Folgeanfragen an die Server-Instanz leiten, die den Task-Zustand hält.
7. Praxis-Implementierung in Go (Task-Store & TTL)
Ein solider Task-Server braucht vier Eigenschaften:
- Asynchroner Worker: Start in einer Goroutine, ohne den Handler zu blockieren.
- Kooperativer Abbruch:
tasks/cancelstoppt die Arbeit übercontext.CancelFunc. - Rückfragen: Ein Worker kann
input_requiredsetzen und auf die Antwort austasks/updatewarten. - TTL / Garbage Collection: Abgelaufene Tasks werden gelöscht, um Speicherlecks zu verhindern.
Das folgende Muster zeigt die serverseitige Logik; die Typen bilden die JSON-Formen der Spezifikation direkt ab. Wie man es an das SDK anschließt, beschreibt der Abschnitt danach.
package tasks

import (
	"context"
	"maps"
	"sync"
	"time"

	"github.com/google/uuid"
)

// Task entspricht dem DetailedTask der Spezifikation (JSON-Felder 1:1).
type Task struct {
	TaskID         string         `json:"taskId"`
	Status         string         `json:"status"` // working | input_required | completed | failed | cancelled
	StatusMessage  string         `json:"statusMessage,omitempty"`
	CreatedAt      time.Time      `json:"createdAt"`
	LastUpdatedAt  time.Time      `json:"lastUpdatedAt"`
	TTLMs          int64          `json:"ttlMs"`
	PollIntervalMs int64          `json:"pollIntervalMs,omitempty"`
	InputRequests  map[string]any `json:"inputRequests,omitempty"`
	Result         any            `json:"result,omitempty"` // CallToolResult
	Error          any            `json:"error,omitempty"`  // JSON-RPC-Fehler

	cancel  context.CancelFunc
	waiting map[string]chan any // offene inputRequests -> Antwortkanal
}

type Store struct {
	mu    sync.Mutex
	tasks map[string]*Task
	ttl   time.Duration
}

func NewStore(ttl time.Duration) *Store {
	s := &Store{tasks: map[string]*Task{}, ttl: ttl}
	go s.cleanupLoop()
	return s
}

// Job ist die eigentliche Arbeit. ask stellt eine Rückfrage und blockiert bis zur Antwort.
type Job func(ctx context.Context, status func(string), ask func(key string, req any) (any, error)) (any, error)

// Start legt den Task an, BEVOR die Antwort gesendet wird (Spec: "durably created").
func (s *Store) Start(job Job) Task {
	ctx, cancel := context.WithCancel(context.Background())
	now := time.Now().UTC()
	t := &Task{
		TaskID: uuid.NewString(), // volle UUID: IDs müssen unerratbar sein
		Status: "working", CreatedAt: now, LastUpdatedAt: now,
		TTLMs: s.ttl.Milliseconds(), PollIntervalMs: 5000,
		cancel: cancel, waiting: map[string]chan any{},
	}
	s.mu.Lock()
	s.tasks[t.TaskID] = t
	snapshot := *t
	s.mu.Unlock()

	go func() {
		res, err := job(ctx, func(msg string) { s.set(t, "", msg) }, func(key string, req any) (any, error) {
			ch := make(chan any, 1)
			s.mu.Lock()
			t.waiting[key] = ch
			if t.InputRequests == nil {
				t.InputRequests = map[string]any{}
			}
			t.InputRequests[key] = req
			s.mu.Unlock()
			s.set(t, "input_required", "")
			select {
			case resp := <-ch:
				return resp, nil
			case <-ctx.Done():
				return nil, ctx.Err()
			}
		})
		s.mu.Lock()
		defer s.mu.Unlock()
		switch {
		case ctx.Err() != nil:
			t.Status = "cancelled"
		case err != nil:
			t.Status = "failed"
			t.Error = map[string]any{"code": -32603, "message": err.Error()}
		default:
			t.Status, t.Result = "completed", res // auch isError:true ist "completed"
		}
		t.InputRequests, t.LastUpdatedAt = nil, time.Now().UTC()
	}()
	return snapshot
}

// Update verarbeitet tasks/update: unbekannte oder bereits beantwortete Schlüssel werden ignoriert.
func (s *Store) Update(id string, responses map[string]any) bool {
	s.mu.Lock()
	defer s.mu.Unlock()
	t, ok := s.tasks[id]
	if !ok {
		return false // -> JSON-RPC -32602
	}
	for key, resp := range responses {
		if ch, open := t.waiting[key]; open {
			ch <- resp
			delete(t.waiting, key)
			delete(t.InputRequests, key)
		}
	}
	if len(t.waiting) == 0 && t.Status == "input_required" {
		t.Status = "working"
	}
	t.LastUpdatedAt = time.Now().UTC()
	return true
}

// Cancel ist kooperativ: quittieren, Kontext abbrechen, Endzustand setzt der Worker.
func (s *Store) Cancel(id string) bool {
	s.mu.Lock()
	defer s.mu.Unlock()
	if t, ok := s.tasks[id]; ok {
		t.cancel()
		return true
	}
	return false
}

// Get liefert eine Kopie für tasks/get (bzw. notifications/tasks).
func (s *Store) Get(id string) (Task, bool) {
	s.mu.Lock()
	defer s.mu.Unlock()
	t, ok := s.tasks[id]
	if !ok {
		return Task{}, false
	}
	c := *t
	c.InputRequests = maps.Clone(t.InputRequests) // Kopie, damit Serialisierung außerhalb des Locks sicher ist
	return c, true
}

func (s *Store) set(t *Task, status, msg string) {
	s.mu.Lock()
	defer s.mu.Unlock()
	if status != "" {
		t.Status = status
	}
	if msg != "" {
		t.StatusMessage = msg
	}
	t.LastUpdatedAt = time.Now().UTC()
}

func (s *Store) cleanupLoop() {
	for range time.Tick(10 * time.Minute) {
		s.mu.Lock()
		for id, t := range s.tasks {
			if time.Since(t.CreatedAt) > s.ttl {
				t.cancel()
				delete(s.tasks, id)
			}
		}
		s.mu.Unlock()
	}
}
Im Tool-Handler ruft der Server store.Start(...) auf und gibt den zurückgelieferten Task mit resultType: "task" als Antwort auf tools/call zurück – aber nur, wenn die Anfrage die Extension in _meta deklariert hat. Andernfalls arbeitet er synchron oder antwortet mit -32021.
Anschluss an das go-sdk
Das offizielle go-sdk (Stand v1.8.0) bringt keine fertige Task-Implementierung mit – weder die experimentelle Fassung von 2025-11-25 noch die Extension. Der Stand der Arbeit ist in Issue #626 nachzulesen: Die Capability-Aushandlung und der Task-Typ liegen als Pull Requests vor; offen ist vor allem die Designfrage, wo das SDK die Lebensdauer eines Tasks verwalten soll. Die Referenzimplementierung ist derzeit das TypeScript-Paket im Repository ext-tasks.
Das SDK bietet aber alle Erweiterungspunkte, die man für die Extension braucht:
| Baustein der Extension | Erweiterungspunkt im go-sdk |
|---|---|
Extension in server/discover bewerben |
ServerCapabilities.AddExtension |
tools/call abfangen und CreateTaskResult liefern |
Server.AddReceivingMiddleware |
tasks/get, tasks/update, tasks/cancel |
mcp.AddReceivingCustomMethod |
inputRequests / inputResponses |
mcp.InputRequestMap, mcp.InputResponseMap (MRTR) |
Genau darauf baut das Paket mcptasks aus dem mcp-tester auf (github.com/hmsoft0815/mlc_mcptester/pkg/mcptasks). Damit wird ein bestehender Server mit wenigen Zeilen task-fähig – die Tool-Handler selbst bleiben unverändert:
caps := &mcp.ServerCapabilities{Tools: &mcp.ToolCapabilities{}}
mcptasks.Declare(caps) // Extension in server/discover bewerben
s := mcp.NewServer(&mcp.Implementation{Name: "build-server", Version: "1.0.0"},
	&mcp.ServerOptions{Capabilities: caps})
mcp.AddTool(s, buildTool, buildHandler) // ganz normaler Handler

// Diese Tools laufen als Task, wenn der Client die Extension deklariert – sonst synchron.
if err := mcptasks.Enable(s, mcptasks.NewStore(), "docker_build"); err != nil {
	log.Fatal(err)
}
Braucht ein Handler unterwegs eine Eingabe, ruft er mcptasks.RequestInput(ctx, mcp.InputRequestMap{...}) auf; der Task wechselt dann auf input_required, bis der Client per tasks/update antwortet. Mit mcptasks.IsTask(ctx) erkennt der Handler, ob er als Task läuft, und kann außerhalb eines Tasks auf den synchronen MRTR-Weg ausweichen. Eine Einschränkung: mcptasks setzt die statusMessage selbst („in progress“, „completed“); eigene Fortschrittstexte aus dem Handler heraus unterstützt das Paket derzeit nicht – dafür braucht man einen eigenen Store wie oben.
Client-seitig ist die Lage schwieriger: Der go-sdk-Client erwartet auf tools/call fest ein CallToolResult und verwirft die Felder eines CreateTaskResult. Wer einen Go-Client für Tasks braucht, muss die Anfragen derzeit an der typisierten API vorbei senden.
Testen mit `mcp-tester`
Ob ein Server die Extension korrekt umsetzt, prüft der mcp-tester (Kapitel 14):
# Tool als Task aufrufen und bis zum Ende verfolgen (ab v1.7.0)
mcp-tester call docker_build --task -c ./build-server --args '{"image":"auth-service"}'

# Server gegen die Extension prüfen: Fehlercodes, Task-Handle, ID-Entropie,
# dauerhafte Anlage, jedes tasks/get, Statusübergänge (ab v1.8.0)
mcp-tester tasks -c ./build-server --tool docker_build --args '{"image":"auth-service"}'
In Testskripten stehen dafür call_task, start_task, wait_task, get_task, cancel_task und assert_task_status bereit.
8. Tasks als Hülle für Sub-Agenten
Liest man die Zustandsmaschine noch einmal mit etwas Abstand, beschreibt sie mehr als einen Docker-Build. Sie beschreibt genau das, was ein Sub-Agent braucht: einen delegierten Auftrag mit eigenem Lebenszyklus, den der Haupt-Agent abgibt, beobachtet, bei Rückfragen bedient und am Ende auswertet.
| Was ein Sub-Agent braucht | Was Tasks dafür liefern |
|---|---|
| Auftrag abgeben, ohne zu blockieren | tools/call → sofortiges CreateTaskResult |
| Zwischenstand sehen | statusMessage über tasks/get oder notifications/tasks |
| Rückfrage an Mensch oder Modell | input_required + inputRequests (Elicitation, Sampling) |
| Abbrechen | tasks/cancel |
| Ergebnis übergeben | result im abgeschlossenen Task |
| Absturz des Hosts überleben | dauerhafte taskId, TTL |
| Mehrere Agenten gleichzeitig | mehrere Tasks, je ein Griff |
Tasks allein sind aber noch kein Sub-Agent. Sie sind die Hülle – das Denken findet woanders statt: in einer Agenten-Schleife im Server, die ein eigenes LLM anspricht (etwa ein lokales Qwen) und dabei eigene Werkzeuge benutzt. Ein typisches Beispiel ist ein Review-Server, der Code des Haupt-Agenten auf Duplikate und Hausstandards prüft. Wie man so einen Server baut und wann sich das gegenüber den eingebauten Sub-Agenten des Hosts lohnt, zeigt Kapitel 20, Abschnitt „Der Server als Sub-Agent“.
9. Migration von `2025-11-25`
2025-11-25 (experimentell, SEP-1686) |
2026-07-28 (Extension, SEP-2663) |
|---|---|
Capability tasks.requests.tools.call + Tool-Feld execution.taskSupport |
Extension io.modelcontextprotocol/tasks in den Per-Request-Capabilities |
Client setzt task-Parameter pro Aufruf |
Server entscheidet allein; kein Flag pro Aufruf |
tasks/result (blockierend) |
Ergebnis inline in tasks/get |
tasks/list |
entfallen – Task-IDs selbst speichern |
Rückfragen über Nebenkanal während tasks/result |
inputRequests in tasks/get, Antwort per tasks/update |
notifications/tasks/status |
notifications/tasks über subscriptions/listen |
| Client-seitige Tasks für Sampling/Elicitation | entfallen (SEP-2260: keine unaufgeforderten Server-Anfragen) |
ttl |
ttlMs, dazu pollIntervalMs |
Für bestehende Clients gilt: Wer nach außen ein festes CallToolResult zurückgibt, kann das Polling intern abwickeln und nur das Endergebnis zeigen – die öffentliche Schnittstelle muss sich nicht ändern.
10. Häufige Fehler & Best Practices
| Fehler | Folge | Lösung |
|---|---|---|
| Kurze oder fortlaufende Task-IDs | Fremde Clients können Tasks erraten und Ergebnisse abgreifen | IDs mit ausreichend Entropie (volle UUID, Krypto-Zufall); bei jeder tasks/*-Anfrage Authentifizierung und Berechtigung prüfen |
CreateTaskResult ohne Capability-Prüfung |
Ältere Clients erhalten eine Antwort, die sie nicht verstehen | Extension pro Anfrage in _meta prüfen, sonst synchron arbeiten oder -32021 |
Fachfehler als failed |
Client hält einen Tool-Fehler für einen Protokollfehler | failed nur für JSON-RPC-Fehler; Tool-Fehler sind completed mit isError: true |
| Keine TTL / Cleanup | Server verbraucht mit jedem Tag mehr RAM | Feste TTL (z. B. 1–24 h) und Aufräum-Schleife |
| Kein Abbruch an den Worker weitergereicht | Gekündigter Job läuft weiter und frisst CPU | context.WithCancel() nutzen und in Schleifen auf ctx.Done() prüfen |
pollIntervalMs ignoriert |
Hunderte Anfragen pro Minute | Takt einhalten oder notifications/tasks abonnieren |
| Rückfragen nicht dedupliziert | Nutzer sieht dieselbe Bestätigung bei jedem Poll | Bereits gezeigte inputRequests-Schlüssel merken |
| Task-IDs nur im RAM des Clients | Nach Absturz sind laufende Tasks unauffindbar (es gibt kein tasks/list) |
IDs dauerhaft speichern |
Fazit
Tasks verwandeln MCP von einem synchronen RPC-Protokoll in ein asynchrones, wiederaufnehmbares Job-System. Mit der Extension 2026-07-28 ist das Modell schlanker geworden: drei Methoden, der Server entscheidet, Rückfragen und Ergebnis laufen über tasks/get. Für Entwickler von MCP-Servern bedeutet das: keine Timeouts mehr, keine blockierten Chats – und eine tragfähige Grundlage, um Server als eigenständige Sub-Agenten in Agenten-Workflows einzubinden.
← Kapitel 18: Notifications | Inhaltsverzeichnis | Nächstes Kapitel: Agentische Server & Sampling →
Copyright Michael Lechner – 2026-10-09 (Angleichung an die Tasks-Extension SEP-2663 / Spezifikation 2026-07-28, Abschnitt „Tasks als Hülle für Sub-Agenten“)